Si le preguntamos a alguien cuánto tiempo ha pasado hoy con el móvil, o qué webs visitó antes de comprar unas zapatillas, probablemente se equivoque aunque haya querido responder con sinceridad. La investigación sobre el uso de medios digitales confirma que lo que las personas declaran y lo que sus dispositivos registran coinciden solo de forma moderada. El Passive Data Research parte de esa constatación y, en lugar de preguntar, recoge determinados comportamientos de forma automatizada y consentida, reservando las preguntas para lo que ninguna medición puede ver: el porqué.
Qué es el Passive Data Research y cómo funciona
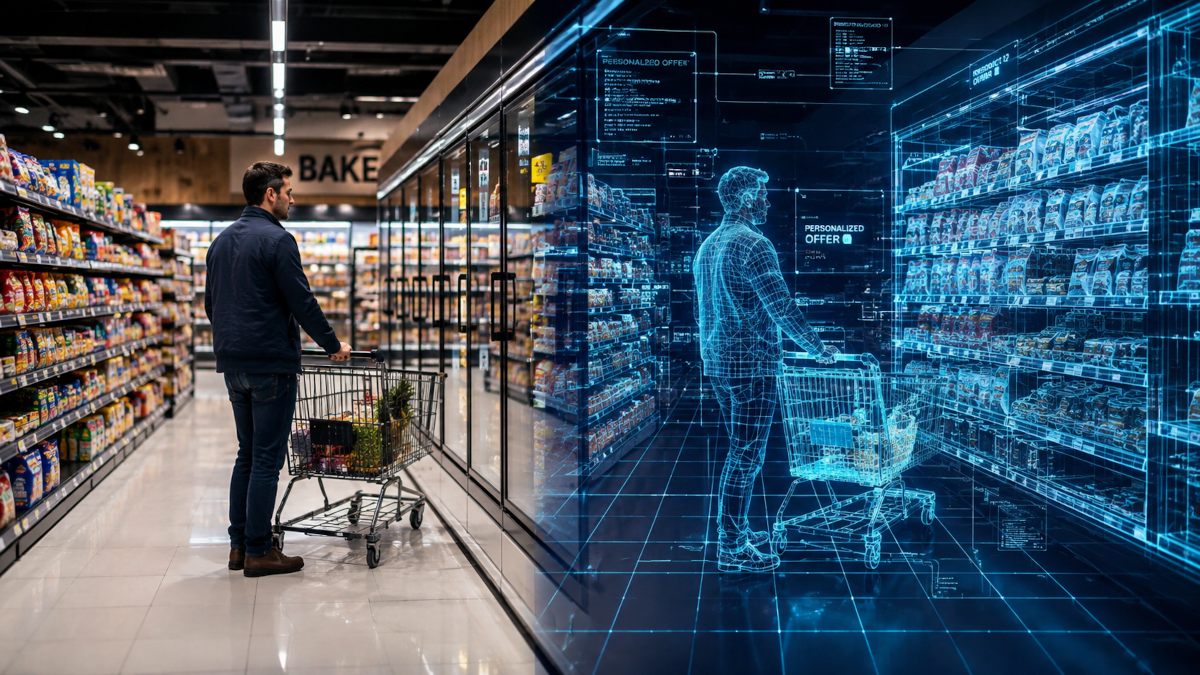
Conviene empezar distinguiendo tres conceptos que a menudo se mezclan. Los passive data son los datos que se generan durante la actividad habitual del consumidor y que se recogen con una intervención mínima por su parte: navegación web, uso de aplicaciones, consumo de contenidos o transacciones, entre otros. El passive metering es una de las técnicas para obtenerlos, y consiste en un medidor, normalmente un software instalado en los dispositivos del participante, que registra su actividad a lo largo del tiempo. El Passive Data Research es el enfoque que integra esos datos en un proyecto de investigación, junto con encuestas y técnicas cualitativas.
En la práctica, el proceso suele ser este. Se invita a los miembros de un panel a participar y se les explica con claridad qué se va a registrar, con qué finalidad y durante cuánto tiempo. Quien acepta instala el medidor en los dispositivos que utiliza (ordenador, móvil o tableta), y a partir de ese momento el software anota qué dominios o aplicaciones se usan y cuándo. Después, esa actividad en bruto se clasifica en categorías con sentido para la investigación, como una visita a un comparador de precios o a un ecommerce, y se vincula, a nivel individual, con las respuestas que el mismo participante da en las encuestas. El panelista puede pausar la medición o retirarse, y determinadas categorías sensibles, como las bancarias, pueden excluirse del registro.
Del recuerdo al comportamiento observado
Una de las aportaciones más claras del dato pasivo es reducir el sesgo de recuerdo (recall bias). Preguntas como “¿cuánto tiempo utilizó ayer esta aplicación?” o “¿qué webs consultó antes de comprar?” exigen una precisión que la memoria rara vez ofrece. Una revisión sistemática con metaanálisis publicada en Nature Human Behaviour en 2021 concluyó que el uso declarado de medios digitales guarda solo una correlación moderada con el uso registrado objetivamente en los dispositivos, y que los autoinformes de los usuarios rara vez reflejan con exactitud su uso real.
A esa dificultad se suma otra: lo que una persona dice que va a hacer no siempre coincide con lo que acaba haciendo. El dato pasivo permite trabajar con preferencias reveladas, es decir, con acciones observadas en contexto real y no solo con recuerdos o intenciones. Pero observar no equivale a verlo todo, como veremos al hablar de los límites del método.
Reconstruir mejor el recorrido de compra
El passive metering resulta especialmente interesante para analizar recorridos digitales. Un consumidor puede buscar un producto, consultar varias marcas, comparar precios, leer opiniones, visitar un ecommerce y abandonar o completar la compra. Preguntarle después por toda esa secuencia depende de su memoria, y cuanto más fragmentado es el recorrido, menos fiable resulta la reconstrucción.
Los datos pasivos permiten observar directamente parte de ese camino: qué canales intervienen y en qué orden, cuánto tiempo transcurre entre interacciones, dónde aparecen los abandonos y qué alternativas se comparan. Un estudio presentado en un congreso de ESOMAR en 2020 lo aplicó al proceso de compra de teléfonos móviles, precisamente porque la investigación basada en lo declarado tiene dificultades para recoger los numerosos puntos de contacto digitales previos a la compra. De este modo, el análisis del recorrido puede pasar de una reconstrucción exclusivamente declarativa a una combinación entre experiencia recordada y comportamiento observado.
Menos esfuerzo para el participante, más continuidad
Otra ventaja es la posibilidad de realizar seguimientos longitudinales con menor esfuerzo activo del panelista. En lugar de repetir cuestionarios sobre cada comportamiento, el medidor puede registrar determinadas variables durante semanas o meses, lo que facilita observar cambios de hábitos, fidelidad o consumo de medios mientras se producen. El participante sigue siendo esencial, pero no necesita informar continuamente de acciones que el sistema puede registrar, lo que reduce también parte de la fatiga asociada a la investigación activa.
Aplicaciones según el sector y la fuente de datos
Las posibilidades varían según el sector y el tipo de dato disponible:
- En retail y gran consumo, el registro pasivo de compras permite analizar la frecuencia de compra, la composición de la cesta, la repetición y los cambios entre marcas sin depender de que el participante anote cada adquisición.
- En experiencia digital y UX, los datos de navegación y uso ayudan a identificar qué funcionalidades se utilizan realmente, qué recorridos son más frecuentes y en qué punto se abandona un proceso. Además, muestran lo que ocurre fuera del propio sitio o aplicación, como los comparadores o competidores que el usuario consulta antes o después de visitarlo, información que los datos propios de una web no ofrecen.
- En medios y publicidad, la medición pasiva permite estudiar la exposición y el consumo de contenidos entre plataformas y dispositivos sin depender exclusivamente de lo que el participante recuerda haber visto, algo especialmente útil cuando la audiencia se reparte entre varias pantallas.
Los límites: lo que el dato pasivo no ve
Sería un error presentar el dato pasivo como una versión sin errores de la realidad. Bosch y Revilla (2022) han propuesto un marco para clasificar las fuentes de error, y varias son especialmente relevantes para quien encarga o interpreta un estudio de este tipo.
La primera es la cobertura. Según estos autores, los medidores pueden no captar lo que ocurre dentro de determinadas aplicaciones y, sin ir más lejos, las aplicaciones de iOS no son rastreables. Además, el participante puede no tener el medidor en todos sus dispositivos o navegadores: en el caso que analizan, entre el 80,5% y el 85,7% de los participantes tenía al menos un dispositivo o navegador sin medir. A ello se suman los dispositivos compartidos en el hogar, que pueden atribuir al participante la actividad de otra persona, y el hecho de que quien sabe que lo observan puede modificar su comportamiento.
La segunda es la representatividad. Los paneles con medidor son de participación voluntaria y quienes aceptan instalar un software de registro pueden diferir de quienes lo rechazan. Y hay un tercer matiz, más sutil: la ausencia de rastro no equivale a la ausencia de conducta. Si el medidor no registra una visita, puede que no se haya producido o que simplemente no se haya podido captar, y los datos por sí solos no permiten distinguirlo. Nada de esto resta valor al método, pero obliga a presentarlo con honestidad: el dato pasivo corrige algunos sesgos de la información declarada e introduce otros que hay que conocer y gestionar.
Passive data y encuestas: conectar el “qué” con el “por qué”
El principal límite del dato pasivo es que la medición puede mostrar que un consumidor visitó varias veces una web y abandonó el carrito, pero no explica por qué lo hizo. Ahí aparece el valor de los modelos híbridos: el dato pasivo permite saber qué ocurrió, las encuestas miden percepciones, actitudes e intenciones, y la investigación cualitativa profundiza en las motivaciones.
Un ejemplo ilustrativo muestra cómo se combinan. Un medidor detecta que una parte de los participantes abandona la compra en el último paso de un ecommerce. A partir de ese patrón, y no antes, se lanza una encuesta breve dirigida solo a esas personas, o se convocan algunas entrevistas, para entender si el motivo fue el coste del envío, la desconfianza hacia el método de pago o una simple comparación con otra tienda. La observación ayuda así a formular preguntas más precisas, y las preguntas dejan de gastarse en lo que ya sabemos.
Privacidad y consentimiento: una condición imprescindible
La recogida pasiva exige una atención especial a la privacidad, precisamente porque el participante no interviene en cada registro.
ESOMAR y GRBN la incluyen expresamente en su guía para la recogida de datos primarios, que define la recogida pasiva como la observación, medición o registro de las acciones o el comportamiento de una persona. Esa guía establece, entre otras cosas, que el investigador debe ser plenamente transparente sobre la información que va a recoger, su finalidad, cómo se protegerá y con quién podría compartirse; que el participante debe poder retirarse y obtener la eliminación de sus datos en cualquier momento; y que, si el planteamiento cambia de forma relevante (por ejemplo, al añadir datos de localización), hay que informar de nuevo a los participantes para que decidan si continúan.
En los proyectos que se prolongan durante varias oleadas o meses, como ocurre con muchas mediciones pasivas, la guía añade además que el consentimiento debe refrescarse periódicamente, recordando a los participantes qué datos se recogen, con qué finalidad y cómo se utilizan.
A ello se suma la normativa de protección de datos, como el RGPD, y unas buenas prácticas que conviene aplicar desde el diseño: recoger solo lo necesario para el objetivo del estudio, excluir las categorías sensibles y permitir al participante pausar la medición.
Observar más para preguntar mejor
El Passive Data Research no plantea dejar de escuchar al consumidor, sino evitar preguntarle aquello que puede observarse con mayor precisión. Su potencial está en combinar comportamiento y contexto: utilizar el passive metering para descubrir qué sucede y reservar las encuestas y las técnicas cualitativas, como las entrevistas o los focus groups, para comprender por qué sucede.
Para la investigación de mercados, ese cambio puede ser especialmente relevante: menos preguntas sobre lo que el consumidor hizo y mejores preguntas sobre lo que realmente significa su comportamiento.
Referencias bibliográficas
Bosch, O. J. & Revilla, M. (2022). When survey science met web tracking: Presenting an error framework for metered data. Journal of the Royal Statistical Society: Series A (Statistics in Society), 185(Suppl. 2).
ESOMAR & GRBN (2019). Guideline for Researchers and Clients Involved in Primary Data Collection.
Parry, D. A., Davidson, B. I., Sewall, C. J. R., Fisher, J. T., Mieczkowski, H. & Quintana, D. S. (2021). A systematic review and meta-analysis of discrepancies between logged and self-reported digital media use. Nature Human Behaviour, 5(11), 1535-1547.
Saigal, A., Surtani, S., Raj, P., Adam, Z., Agarwal, A. & Bhatia, H. (2020). Passive measurement: Path to purchase. ESOMAR Asia Pacific 2020, Insights Festival.
¡Podemos ayudar!
Este tipo de retos son habituales en nuestros estudios de mercado para Gran Consumo.